AI 不是装饰:它靠摄像头“看”,靠语音“答”
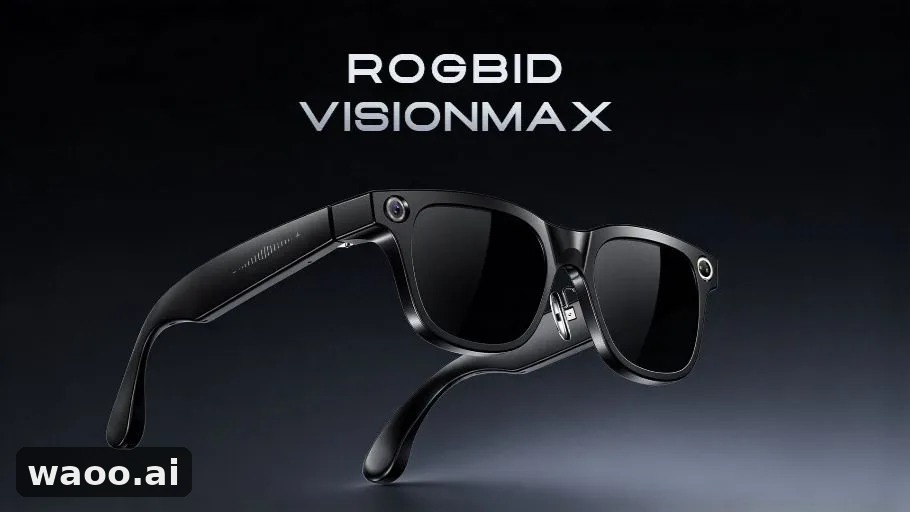
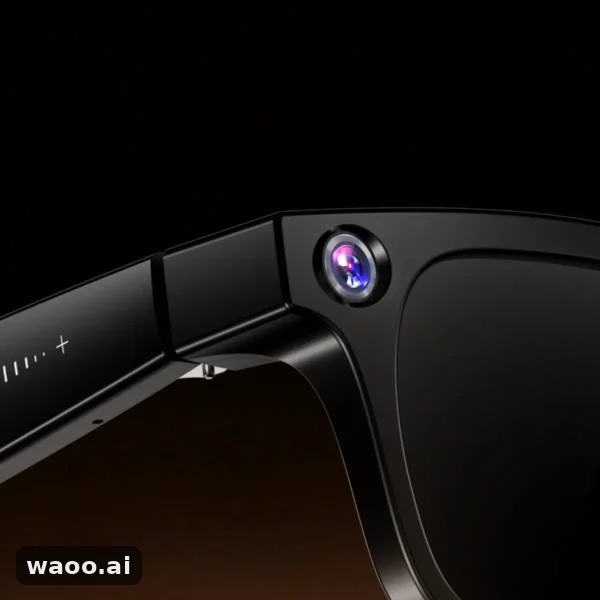
VisionMax 内置的是一个多模态 AI 助手,官方说法是它由大语言模型驱动。使用方式很直白:镜腿上的麦克风接收语音指令,摄像头负责看用户视野里的画面,然后由 AI 给出回答。按厂商列举的用途,用户可以让它识别眼前的东西、做免手问答、把会议内容转成文字、估算食物热量,甚至给一点日常建议。换句话说,AI 在这里不是附加功能,而是主要交互方式——不用掏手机、不用点屏幕,开口问、眼镜看。
需要说清的是,哪些不算 AI。六轴陀螺仪防抖、电子防抖 EIS、双麦克风环境降噪、摘下来自动休眠,这些都是常见的传感器与信号处理,不该被当成 AI 能力来宣传。真正需要模型参与的是“看见画面之后的理解与生成回答”这一段。而这一段目前只有厂商描述,没有第三方实测,识别准不准、翻译延迟多少、是否需要联网才能用,公开材料里都没有答案。翻译语种数目也存在“139 种”与“100 多种”两种口径。


 发表于 2026-10-16 16:48:57