它靠什么“懂”人:一个还没完成的 VLE 模型
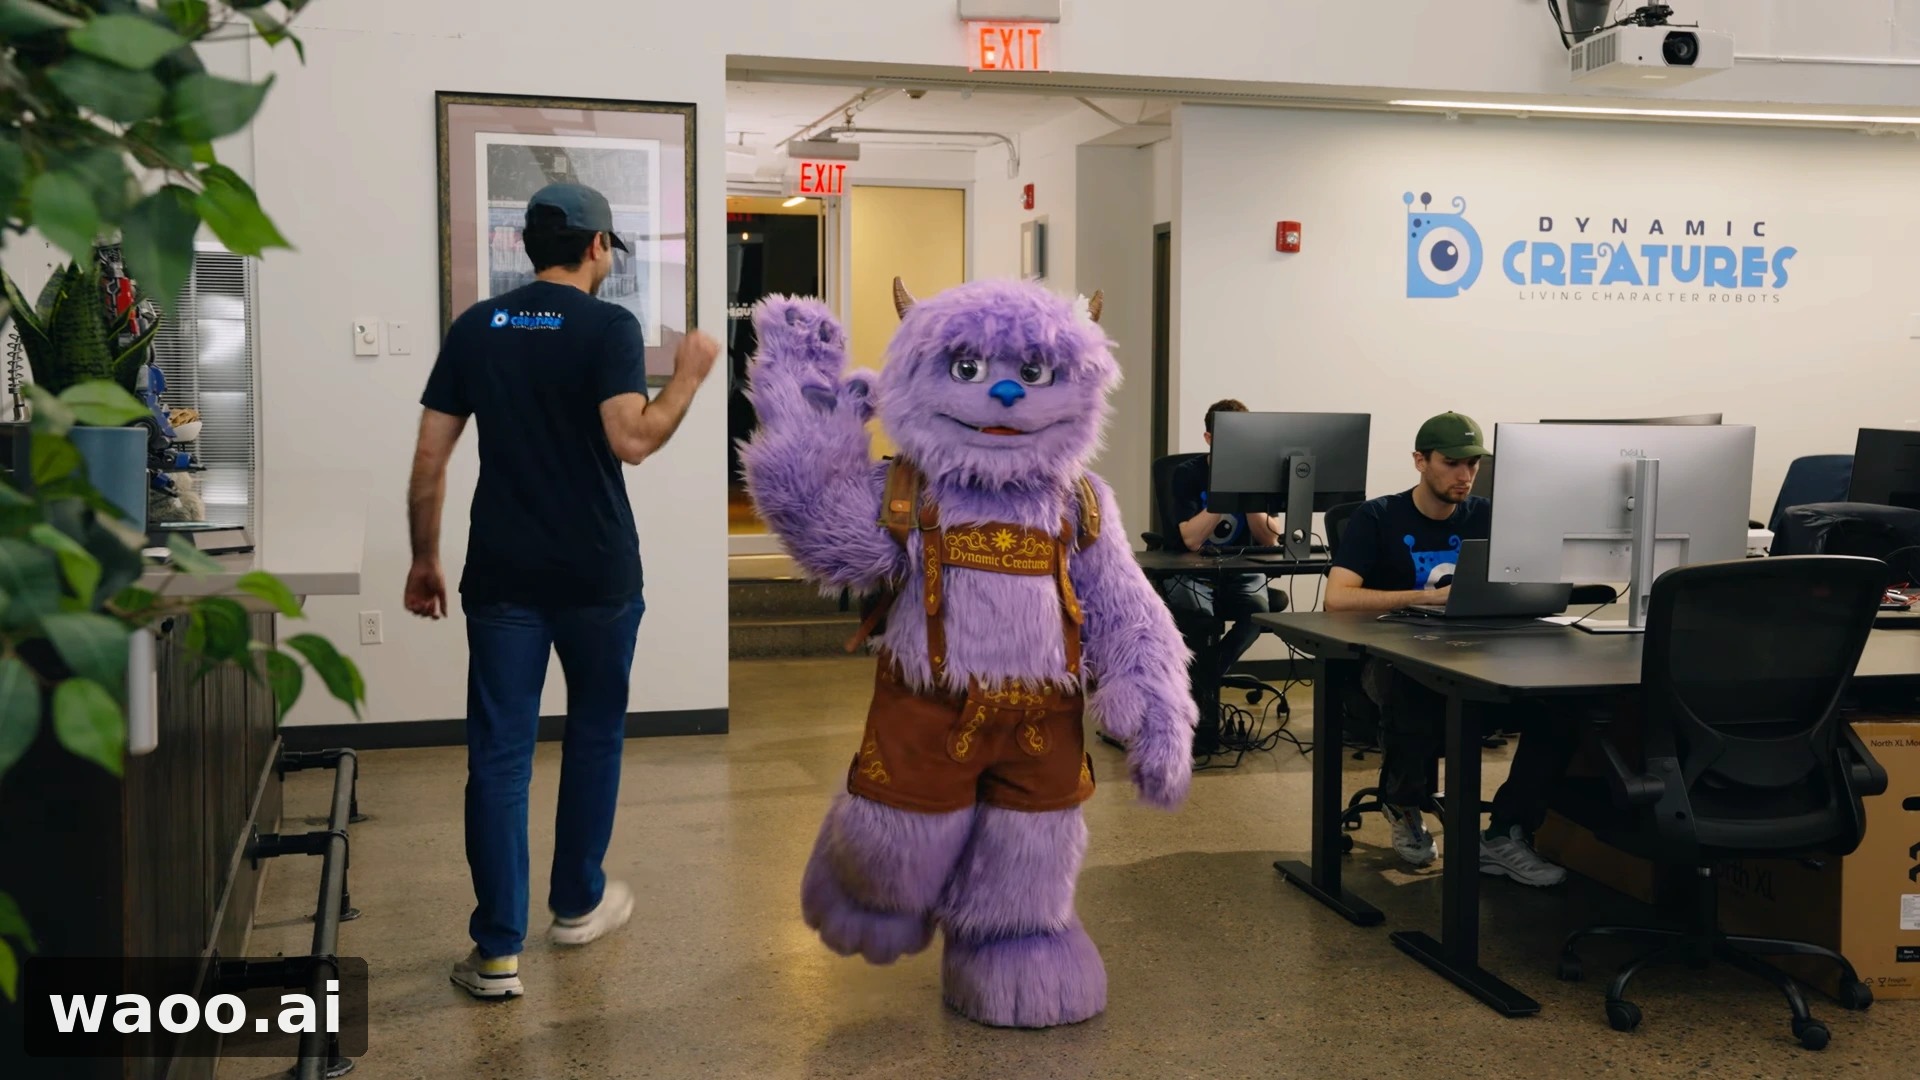
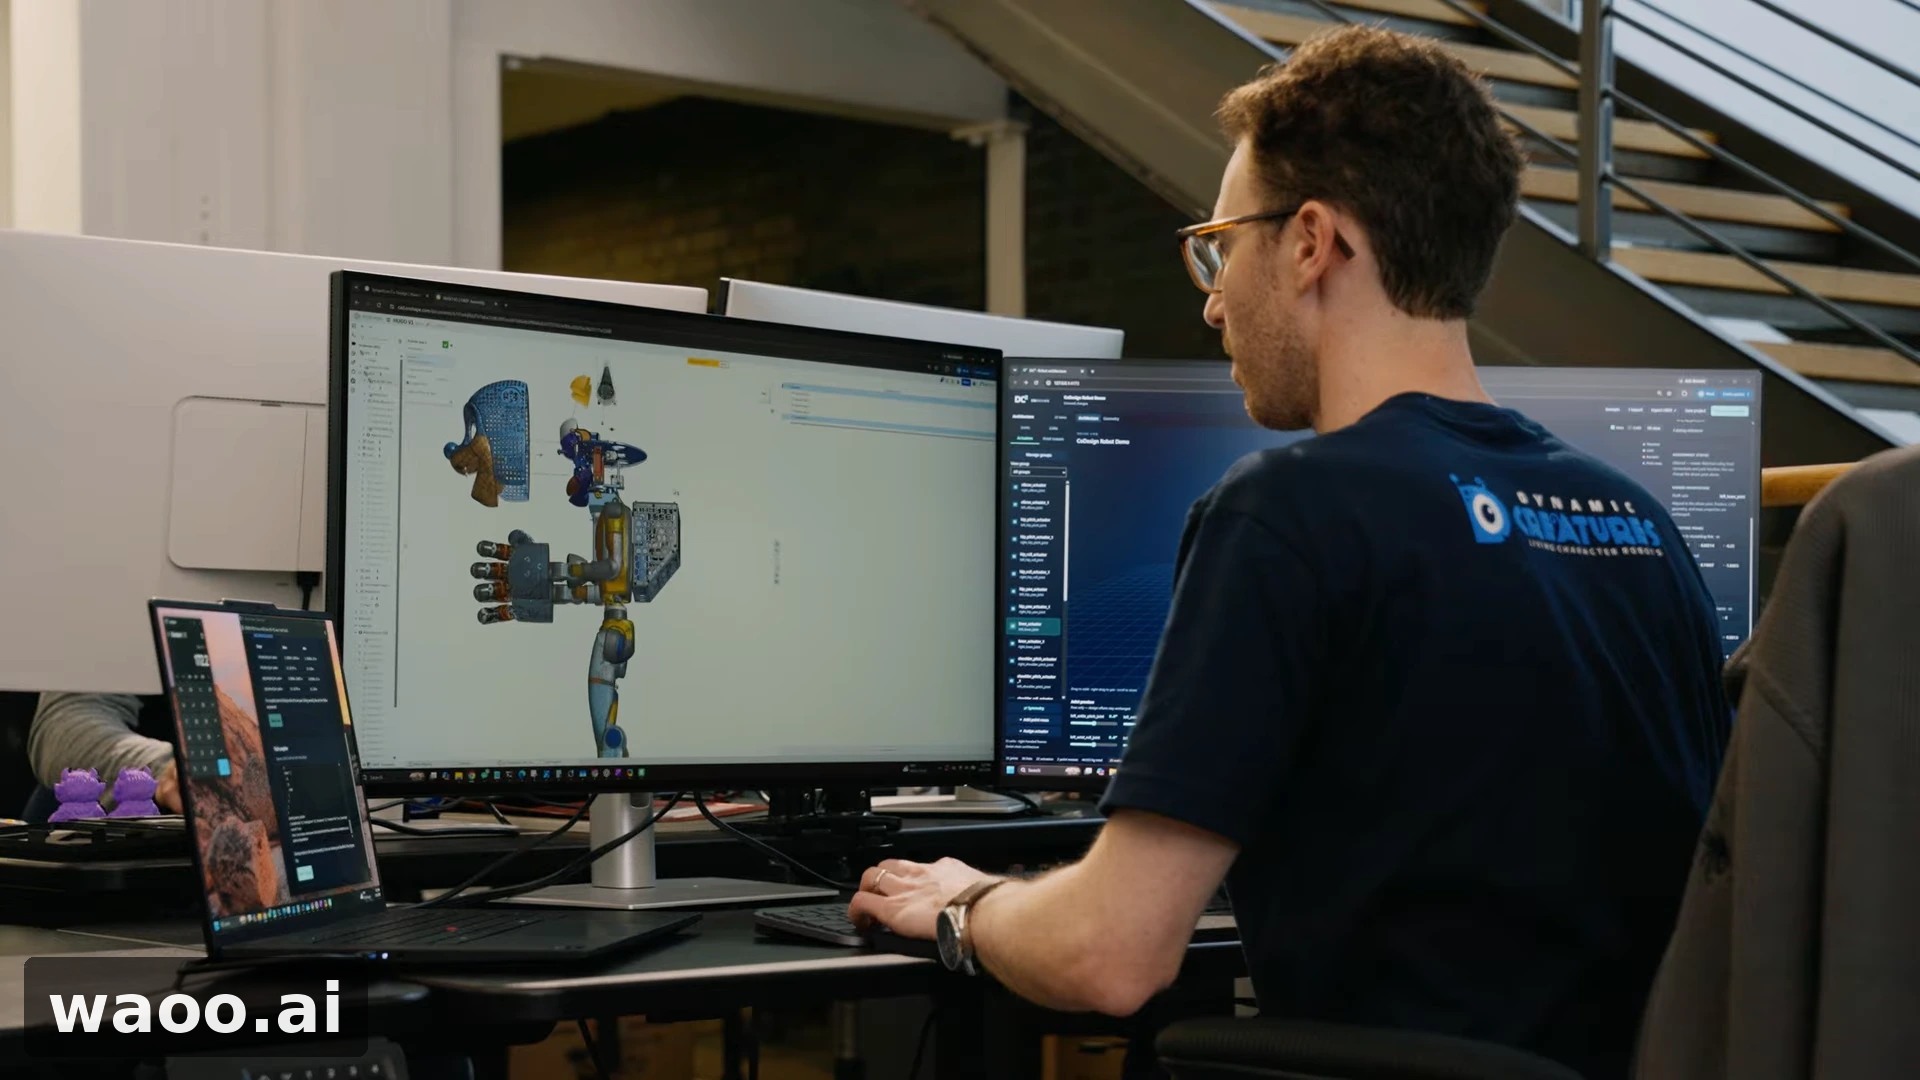
这才是 Hugo 的 AI 核心。Dynamic Creatures 称其强化学习团队正在开发 Vision-Language-Expression(视觉—语言—表达)模型,把感知和语言接到手势、动作与情绪表达上,目标是让 Hugo 能理解眼前发生的相遇,并对面前的人做出自然回应。注意措辞:是“正在开发”,不是已经完成,也不是已经商用。
公司同时表示,正在开发与人近距离互动所需的导航和安全能力。换句话说,它得先知道人在哪、离得多近、能不能安全靠近,才有机会“表演”。但媒体也指出,这段宣传片并没有说明 Hugo 的行为有多少是自主的,也没证明它可以在无人监督的情况下和客人待在一起。会演一段固定戏,和能应付随时冒出来的情况,是两件事。


 发表于 2026-10-16 18:40:58