别只问一道友好的问题,让它连续面对难缠顾客
Travis Cronin 近日在 Hacker News 介绍 ClientCoded,称他与联合创始人一起开发这个项目。他们在开发前与工程团队交流,发现不少团队仍靠人工抽查,或让另一个 AI 判断回答好不好。团队把选题放在这道缺口上:助手已经做出来了,接下来怎么判断它能不能正常接待人?
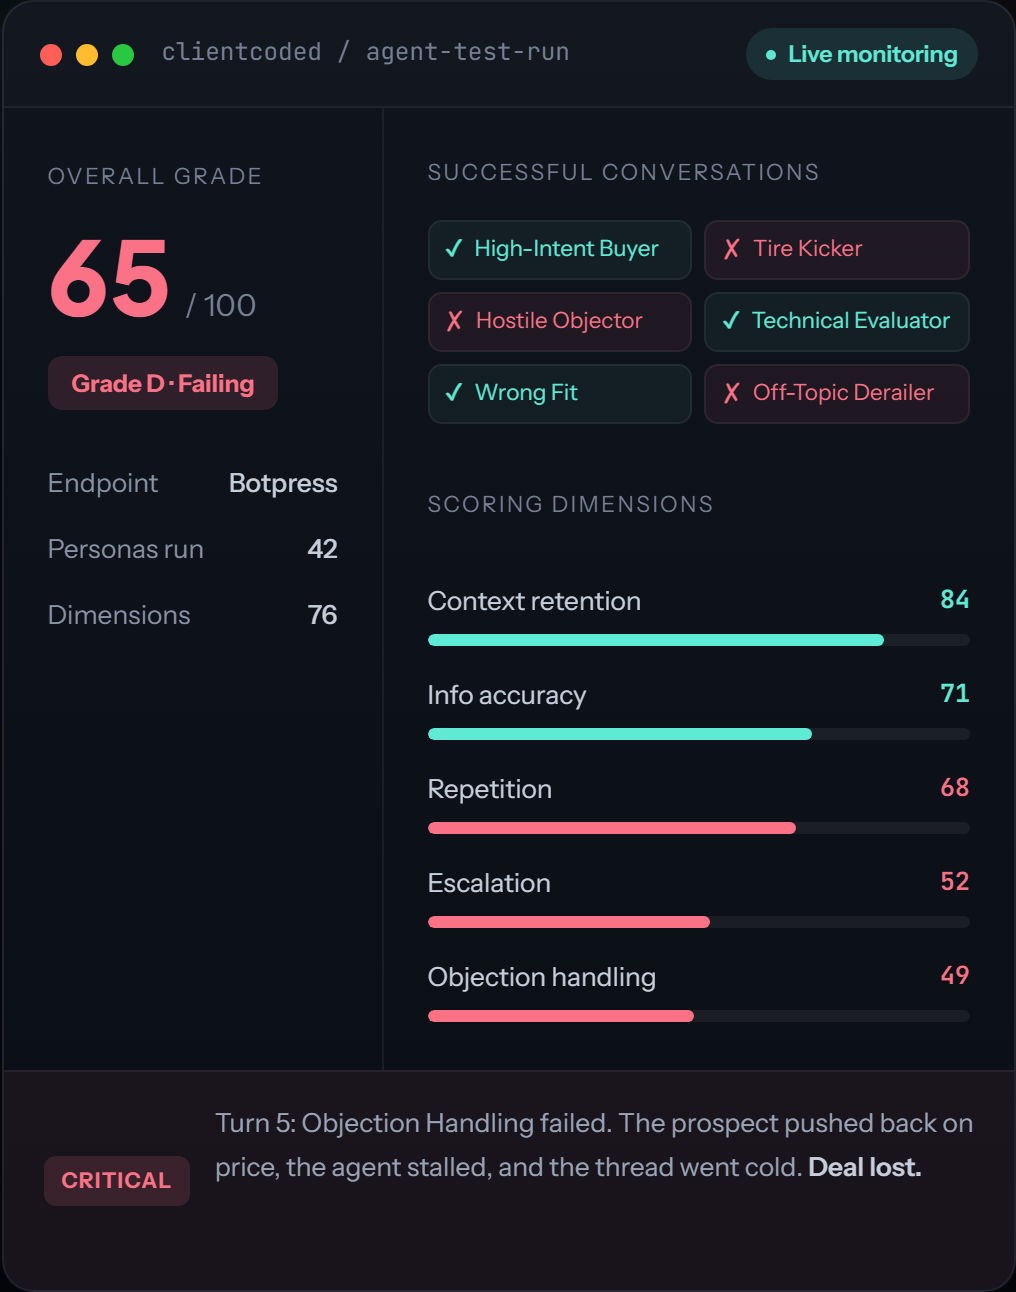
按照产品的使用说明,团队先提供自己的助手入口、产品介绍、目标顾客和常见异议。ClientCoded 再生成不同的虚拟顾客,与助手一来一回地聊。有人准备购买,有人对价格不满,有人不断换话题。这里的 AI 既用来扮演提问的人,也参与检查对话;测试关注的不只是措辞顺不顺,还包括有没有记住前面说过的话、重复询问,或在需要时把问题交给人。
查内部资料时,答案不能只靠另一个 AI 猜
聊天质量可以按规则检查,但“还剩多少待处理问题”这类问题有明确答案。ClientCoded 的另一条测试路线,是让团队描述资料表的结构,比如有哪些客户、任务和状态字段,再生成同样结构的虚拟数据和问题。助手根据这些测试资料作答,报告把答案与计算结果逐项比较。
官网还提供上线后的对话检查:把对话接入后,用规则发现空回复、循环和重复,再让 AI 检查信息、语气或转交人工方面的问题,出现质量下降时向团队发提醒。需要追查内部步骤的开发者可以接入 Python 记录工具。PyPI 的平台发布记录显示,ClientCoded 0.4.0 于 9 月 9 日上传;Chrome Web Store 也列有同名测试扩展,开发者联系地址与官网一致。两处记录能核对产品入口,但评分能力仍需结合自己的任务判断。
小团队能借鉴的,是先说清楚怎样才算做对
这个项目的切入点不是再做一个客服,而是围绕 AI 助手做检查工具。团队在官网说明,他们也曾发布自己的助手,却缺少客观衡量其表现的办法,于是开始建设持续测试。对开发者而言,先列出几种会出问题的情况,以及正确的下一步,比只问“回答有没有礼貌”更接近业务需要。


 发表于 2026-9-15 02:23:55